 AI트렌드 & 개발자 이야기
1비트 LLM과 초양자화: 저전력 AI의 혁신
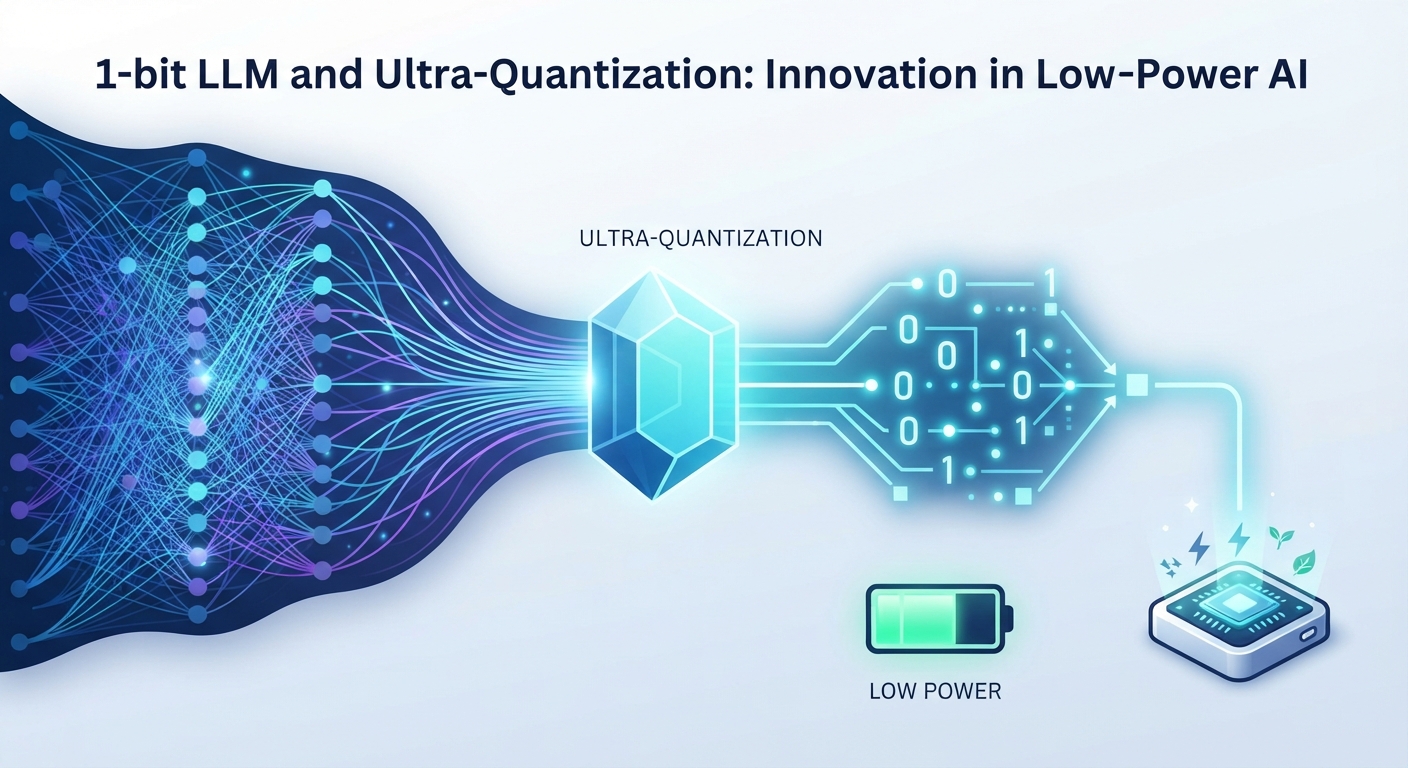
인공지능(AI) 모델의 크기가 폭발적으로 증가함에 따라 고성능 GPU의 수요와 과도한 전력 소비가 치명적인 병목 현상으로 떠오르고 있습니다. 기존의 모델 확장 방식이 막대한 에너지와 연산 비용을 요구하는 가운데, 최근 '1비트 LLM(BitNet b1.58)'과 초양자화(Extreme Quantization) 기술이 AI 반도체 및 모델 경량화의 새로운 대안으로 급부상하고 있습니다. 가중치를 오직 -1, 0, 1의 세 가지 값으로 제한하여 연산 구조 자체를 바꾸는 이 기술이 왜 지금 글로벌 AI 생태계의 주목을 받고 있는지 살펴봅니다.
1. 곱셈 연산의 종말: BitNet과 1.58비트 파라미터의 혁신
기존 거대언어모델(LLM)은 FP16(16비트 부동소수점) 또는 INT8(8비트 정수)을 사용하여 복잡한 행렬 곱셈 연산을 수행합니다. 이는 방대한 메모리 대역폭과 높은 전력을 소모하는 주원인입니다.
- 삼진법(Ternary) 가중치 적용: 1비트 LLM의 핵심 아키텍처인 BitNet b1.58은 가중치 값을 {-1, 0, 1}의 삼진 논리로 제한합니다. 이를 통해 각 파라미터를 약 1.58비트의 용량만으로 효율적으로 표현합니다.
- 덧셈 연산으로의 전환: 가중치가 -1, 0, 1로 고정되면 고비용의 '행렬 곱셈(Matrix Multiplication)' 연산이 단순한 '행렬 덧셈' 연산으로 대체됩니다. 이는 칩 내부의 연산 루틴을 획기적으로 단순화시킵니다.
2. 초저전력·초고속 추론과 에지 AI의 대중화
초양자화 기술은 대규모 데이터센터의 비용절감뿐만 아니라 온디바이스(On-device) AI 환경에도 파괴적인 변화를 가져오고 있습니다.
- 전력 및 메모리 대역폭 절감: 메모리 읽기/쓰기 과정에서 소모되는 전력이 기존 대비 최대 10배 이상 줄어들며, GPU 전력 소모를 획기적으로 낮출 수 있습니다.
- 온디바이스 AI의 고성능화: 스마트폰, 로봇, IoT 기기 등 전력과 메모리가 제한된 환경에서도 7B~13B 규모의 거대 모델을 지연 없이 실시간으로 구동할 수 있게 됩니다.
3. 성능 유지와 상용화를 위한 도전 과제
비트 수를 획기적으로 줄이면서도 언어 이해 능력의 손실을 최소화하는 것이 초양자화 기술의 핵심 과제입니다.
초기 1비트 연구는 모델의 정확도 저하가 심각했으나, 최근 양자화 인식 훈련(Quantization-Aware Training) 기법의 발전으로 풀프리시전(Full-precision) 모델에 비견되는 정밀도를 달성하고 있습니다. 또한, 기존 GPU는 행렬 곱셈에 최적화되어 있어, 1비트 전용 NPU(신경망 처리 장치) 및 맞춤형 AI 칩셋 개발이 함께 가속화되고 있습니다.
결론: AI 지속가능성을 향한 패러다임의 전환
1비트 LLM과 초양자화 트렌드는 단순히 모델 크기를 줄이는 단순 경량화 기술이 아닙니다. 이는 AI 산업의 가장 큰 걸림돌인 전력 위기와 추론 비용 장벽을 극복하고, 지속 가능한 AI 생태계를 구축하기 위한 필연적인 패러다임 전환입니다. 대용량 추론 비용 감소와 에지 디바이스의 지능화가 촉진됨에 따라, 향후 맞춤형 AI 반도체 시장과 결합한 초경량 고성능 모델의 도입이 빠르게 확산될 전망입니다.
댓글
아직 댓글이 없습니다.